
生成AIを業務に取り入れたいものの、どのサービスやモデルから検討すべきか分からず、社内説明や稟議が進まない担当者は少なくありません。
「情報漏えいは大丈夫か」「PoCを始めても本番で費用が膨らまないか」と、セキュリティやコストの不安を感じている方も多いのではないでしょうか。
本記事では、AWS Bedrockの全体像と主要機能、ユースケース、モデル選定、セキュリティ、料金までを、導入判断に使える形でご紹介します。
テクノプロはAWSの構築から運用まで幅広く支援しています
まず結論|Amazon BedrockはAWS上の生成AI基盤
Amazon Bedrock(以下、Bedrock。検索では「aws bedrock」とも呼ばれます)は、複数の基盤モデル(大量のデータで事前学習された汎用AIモデル)を共通のAPIで使えるAWSのフルマネージドサービスです。RAGやAgents、Guardrailsを組み合わせ、企業向けの生成AIアプリケーションを作る基盤として使えます。
Bedrockでできることと限界
Bedrockでは、文章の生成・要約、質問応答、画像生成などを、サーバー管理なしで利用できます。社内文書を検索して回答させる構成や、業務システムと連携する構成も、AWSのサービスと組み合わせて作れます。
一方で、Bedrockは業務課題を自動で解決する完成品ではありません。回答の精度は、対象データの質、プロンプト設計、評価の進め方に左右されます。利用できるモデルや機能はリージョンごとに異なるため、事前の確認も必要です。
SageMakerや外部生成AI APIとの違い
Amazon SageMakerは、機械学習モデルを自社で開発・学習・運用するための基盤です。これに対しBedrockは、提供済みの基盤モデルをAPIで使い、アプリケーションに組み込むことが中心です。
外部の生成AIサービスと比べると、既存のAWS環境のIAM、監査ログ、ネットワーク制御と同じ統制の中で運用できる点が特徴です。AWS 生成AIの基盤を一本化したい企業に向いています。
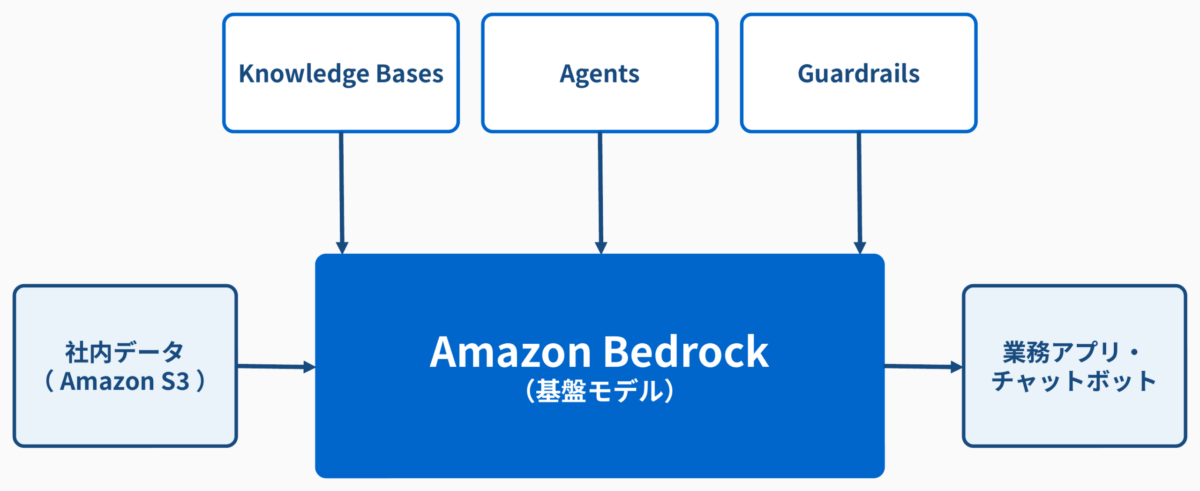
Amazon Bedrockの主要機能
Amazon Bedrock 機能は、導入判断に必要な粒度では、次の4つに整理できます。
- 基盤モデル:複数のモデルから用途に合うものを選ぶ
- Knowledge Bases:社内データを参照して回答させる
- Agents:業務の手順を実行させる
- Guardrails:入出力を安全に制御する
基盤モデルの利用とモデル選定の考え方
Bedrockでは、AmazonのモデルやAnthropicなど複数の提供元の基盤モデルを、同じ方法で呼び出せます。用途ごとにモデルを切り替えやすく、特定のモデルに固定されにくい点が利点です。モデル選定は、後述の「モデル選定とRAG設計のポイント」で整理します。
Knowledge BasesによるRAG構成
RAG(検索拡張生成:社内データを検索し、その結果を根拠に回答させる方式)を実現するのが、Knowledge Bases for Amazon Bedrockです。Amazon S3などに置いた文書を取り込み、検索と回答生成までを一連で構成できます。社内チャットボットやナレッジ検索の中核になります。
Agentsによる業務タスク自動化
Agents for Amazon Bedrockは、利用者の依頼を複数の手順に分解し、AWS Lambdaなどを通じて業務システムの操作を実行させる機能です。実行できる操作の範囲は、権限で絞り込みます。
Guardrailsによる安全対策
Amazon Bedrock Guardrailsは、入力と出力に対して、不適切な内容や禁止話題、個人情報などを制御する機能です。制御できる範囲には限界があるため、詳しくは後述のセキュリティの章で説明します。
代表的なユースケース(Amazon Bedrock ユースケース)
Bedrockの活用は、社内の問い合わせ対応、文書の検索・要約、各部門の業務支援に整理できます。
| 用途 | 主な構成 | 検討時のポイント |
| 社内問い合わせ・ヘルプデスク | Knowledge Basesと社内チャットボット | 規程やFAQの更新頻度、回答の根拠表示 |
| 社内ドキュメント検索・要約 | RAGとナレッジ検索 | 文書ごとのアクセス権限、検索精度 |
| 開発支援 | 基盤モデルによるコード・設計書の補助 | 機密コードの扱い、レビュー体制 |
| 営業・バックオフィス支援 | 文書作成・要約、Agentsとの連携 | 承認フロー、人による最終確認 |
社内問い合わせとドキュメント検索
情シスや人事への問い合わせ対応は、規程や手順書が整っていれば、RAGの効果が出やすい領域です。
開発・営業・バックオフィス業務の支援
各部門の候補は、次のとおりです。いずれも最終判断は人が行う前提にし、誤りを見つける手順を業務に組み込みます。
- 開発:コードや設計書の補助
- 営業:提案書や議事録の要約
- バックオフィス:申請内容の確認や規程の案内
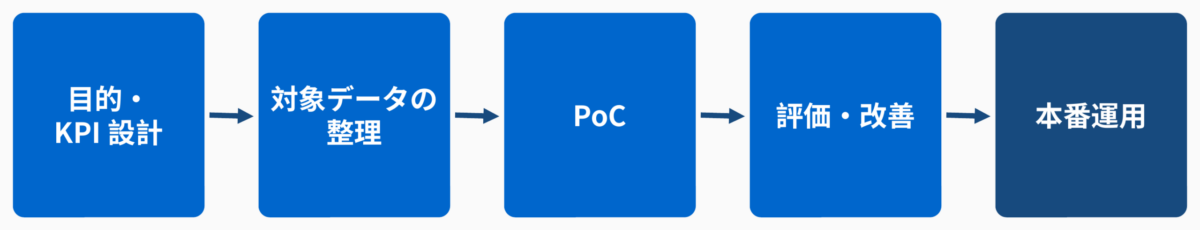
自社に適した活用方法を決める手順
導入は、目的の設計、データの整理、PoC、体制づくりの順に進めると、手戻りを減らせます。
目的・KPIの設計と対象データの整理
最初に、業務課題から逆算して目的とKPIを決めます。たとえば、問い合わせ対応の工数削減や、検索にかかる時間の短縮などです。あわせて、対象データを機密情報・個人情報・公開情報に分け、AIに読ませてよい範囲を決めます。
PoCの進め方と内製・外部委託の整理
PoC(概念実証:本格導入前の小規模な検証)では、評価観点と成功条件を先に決め、対象を限定して始めます。内製か外部委託かは、次の3点で判断します。本番運用まで見据え、監視や変更管理の担当も早めに決めておきます。
- 知見:AWSと生成AIの経験が社内にあるか
- 人員:運用を継続できる担当者を確保できるか
- 期間:稟議や導入までのスケジュールに間に合うか
モデル選定とRAG設計のポイント
精度は、モデル単体ではなく、モデル選定とRAG設計の組み合わせで決まります。
モデル選定の基準と品質評価
モデル選定では、次の4つの基準で比べます。一つのモデルに決め打ちせず、実際の社内データと質問でPoCを行い、比較して選びます。品質評価では、回答の正確さ、根拠の有無、禁止事項の遵守を確認します。
- 精度:社内の質問に正しく答えられるか
- 速度:業務で許容できる応答時間か
- コスト:利用量が増えても見合うか
- 日本語対応:敬語や専門用語を自然に扱えるか
RAG設計で見るべき観点とハルシネーション対策
RAG設計では、データの整備、検索の精度、更新の方法、回答に付ける引用が観点です。ハルシネーション(事実と異なる回答を、もっともらしく生成すること)は、根拠となる文書の範囲で答えさせ、出典を併記し、人が確認する運用で抑えます。プロンプト設計も継続的に見直します。
セキュリティ・ガバナンス(Amazon Bedrock セキュリティ)
セキュリティとガバナンスは、導入判断で最初に確認される論点です。
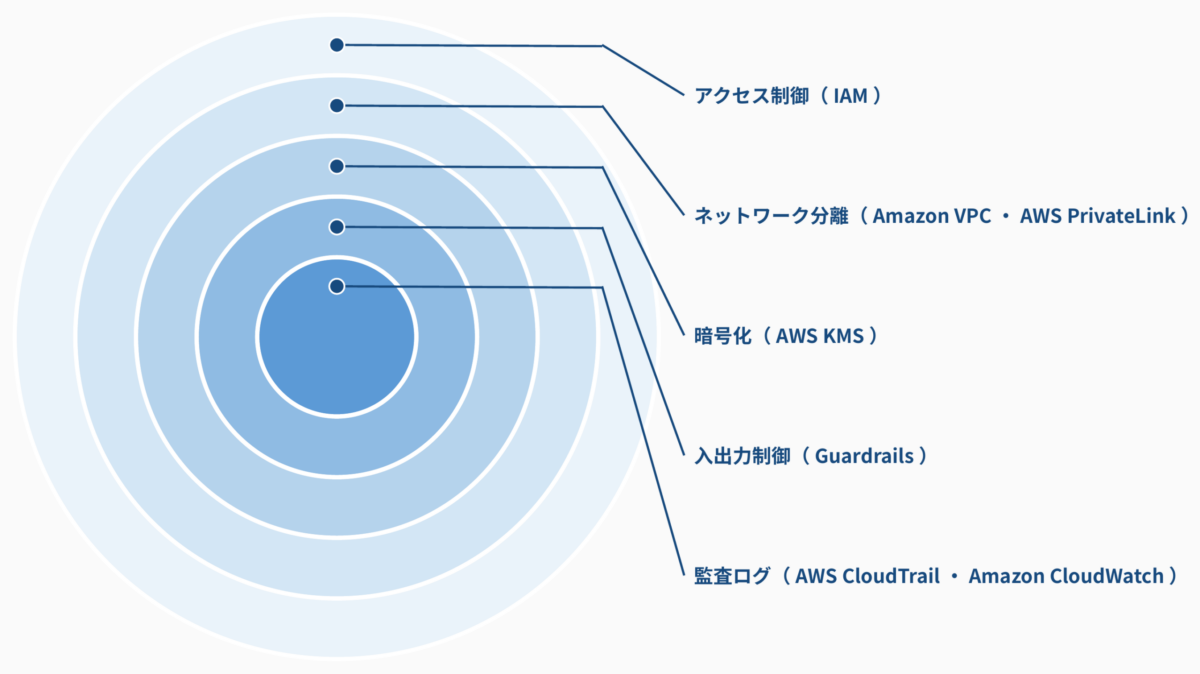
データ保護とアクセス制御
AWSの公式ドキュメントによると、Bedrockはプロンプトと回答を保存・記録せず、AWSのモデルの学習にも使わず、第三者にも提供しないとされています。なお、利用企業がモデル呼び出しログ(既定は無効)を有効にすると、指定したS3やCloudWatch Logsに入出力が保存されるため、ログ自体のアクセス権限と保管期間の設計が必要です。ただし、責任は分担されます。AWSが基盤を守り、利用企業は次の設計を担います。
- 権限:IAMで利用者とモデルへのアクセスを絞る
- 暗号化:AWS KMSで保存データを保護する
- 閉域接続:Amazon VPCとAWS PrivateLinkで通信をインターネットから分離する
個人情報・機密情報の取り扱いとGuardrailsの限界
個人情報や機密情報は、AIに読ませる前に分類し、必要最小限に絞ります。Guardrailsで入出力を制御できますが、すべてのリスクを防げるわけではありません。ガバナンスとして、利用ルール、承認の手順、人による確認を組み合わせます。
監査ログと証跡管理
誰がどのモデルをいつ使ったかは、AWS CloudTrailで操作の記録として確認でき、Amazon CloudWatchで利用状況を監視できます。ただし、CloudTrailに記録されるのは操作の履歴で、プロンプトや回答の内容は含まれません。内容まで残す場合は、モデル呼び出しログを有効にします。監査ログの保管期間と確認の担当を、運用設計の段階で決めておきます。
料金・コストと運用設計(Amazon Bedrock 料金)
単価は改定されるため、金額は掲載せず、費用が増える要因を整理します。最新の料金は、公式の料金ページとAWS Pricing Calculatorで確認してください。
Bedrockの主な課金要素とコスト増加要因
課金の考え方は、次の表のとおりです。
| 課金の考え方 | 内容 | 費用が増えやすいポイント |
| オンデマンド | 処理した量に応じた従量課金 | 利用者や質問数の増加、長い入出力 |
| バッチ推論 | 即時性が不要な処理をまとめて実行 | 対象モデルが限られる場合がある |
| Provisioned Throughput | 処理能力を確保して利用する契約 | 利用率が低いままの固定費 |
| 周辺サービス | S3、Amazon OpenSearch Serverless・Amazon S3 Vectorsなどのベクトルストア、Lambda、CloudWatchなど | RAGやAgents利用時の構成要素の増加。ベクトルストアの種類により、利用が少なくても最低料金が発生する場合がある |
RAGやAgentsを使うと、モデルの利用に加え、検索基盤や実行環境の費用も発生します。Knowledge Bases自体に別料金はなく、埋め込みモデル・ベクトルストア・回答生成モデルの利用分が課金されます。AWSの従量課金は、利用の増加がそのまま請求に反映されるため、PoCの段階から利用量を記録しておきます。
運用体制とFinOps視点の継続最適化
運用では、監視、障害対応、モデルの更新や変更管理の担当を決めます。FinOps(クラウド費用を関係者で可視化し、継続的に最適化する取り組み)の視点では、利用量と費用を用途別に見える化し、不要な利用や過剰な構成を見直します。
導入判断チェックリスト
導入判断は、次の観点を満たしているかで確認します。
判断に使う4つの観点
- ビジネス適合性:解決したい課題とKPIが明確で、効果を測れること
- 技術・データ適合性:対象データが整理され、更新の方法があること
- セキュリティ・契約:責任分界と、個人情報の取り扱いルールが決まっていること
- 次のアクション:PoCの範囲、評価観点、関係者の合意が整っていること
AWS Bedrockでよくある質問
Amazon BedrockとSageMakerの違いは何ですか?
Bedrockは、提供済みの基盤モデルをAPIで使い、アプリケーションに組み込む用途が中心です。SageMakerは、モデルを自社で開発・学習・運用する用途に向きます。目的に応じて使い分け、併用も可能です。
Amazon Bedrockの料金はどのように決まりますか?
利用するモデルと、利用方法(オンデマンド、バッチ、Provisioned Throughputなど)で決まります。RAGでは周辺サービスの費用も加わります。最新は公式で確認してください。
社内データはモデル学習に利用されますか?
AWSの公式ドキュメントでは、プロンプトと回答はAWSのモデルの学習に使われず、第三者にも提供されないとされています。設定や契約条件は、公式情報で確認してください。
RAG構築にはKnowledge Basesが必須ですか?
必須ではありません。Knowledge Bases for Amazon Bedrockは構築を簡単にする選択肢で、検索基盤を自社で組む方法もあります。運用負荷と要件で選びます。
PoCでは何を評価すべきですか?
回答の正確さ、根拠の提示、日本語の品質、応答速度、費用の見込み、セキュリティ要件への適合を評価します。成功条件は、開始前に決めておきます。
まとめ|導入判断は目的・データ・統制・費用の4点で整理する
Amazon Bedrockは、基盤モデル、RAG、Agents、Guardrailsを組み合わせ、企業向けの生成AIを作るための基盤です。導入では、目的とKPI、対象データ、セキュリティとガバナンス、費用と運用体制を整理し、小さなPoCから進めるのが確実です。
ただし実際には、この4点を整理する段階で止まってしまうケースが少なくありません。どの業務から着手すれば効果が出るのか、社内データはそのままAIに読ませてよいのか、PoCで何を確認できれば本番に進む判断ができるのか——いずれも、生成AIと自社業務の両方を踏まえなければ答えが出ない問いだからです。
テクノプロは、AWSアドバンストサービスパートナーとして、AWS認定資格3,000件以上の保有実績を持つ技術者集団です。自社でも生成AIチャットボットを構築・運用しており、その知見を踏まえたご支援が可能です。ご支援の形は、大きく3つからお選びいただけます。
- 請負・準委任:チーム体制で、ユースケースの選定からPoC、本番環境の構築・運用までを一括してお引き受けします
- 技術者派遣:AWSと生成AIの実装経験を持つ技術者がプロジェクトに参画し、自社チームの一員として開発を推進します
- 技術者教育:AWSトレーニングパートナーとして、生成AIを活用・運用できる人材の育成を支援します(年間1,000人の育成実績)
「どの業務から試すべきか相談したい」「PoCの評価項目を一緒に整理したい」という段階でもご相談いただけます。
ぜひテクノプロまでお気軽にご相談ください。
監修者
テクノプロ・ホールディングス株式会社
チーフマネージャー
中島 健治
2001年入社
ITエンジニアとして25年のキャリアを持ち、チーフマネージャーとしてテクノプロ・エンジニアリング社にて金融・商社・製造業など多業界でのインフラ基盤構築に従事してきた。2008年から2024年まで、オンプレミス環境でのストレージ・サーバ統合基盤の設計・構築を手掛け、特に生成AI・データ利活用分野のソリューション開発実績が評価されている。現在は技術知見を活かしたマーケティング戦略を推進している。